
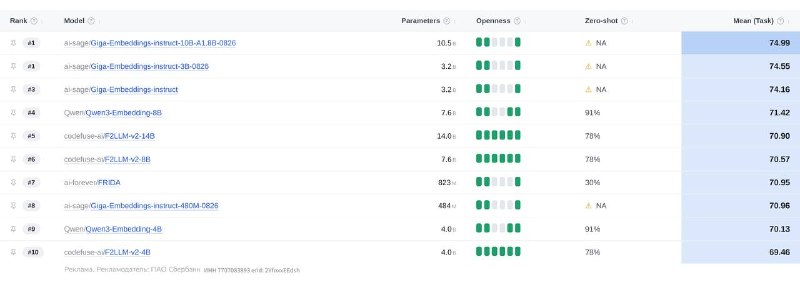
Эмбеддинг-модели превращают текст в числовые векторы, чтобы ИИ искал информацию по смыслу, а не по точному совпадению слов. Это критично для поддержки клиентов, внутренних баз знаний и работы с документами.
В линейку вошли три модели: 480M, 3B и 10B-A1.8B. Все поддерживают vLLM и SGLang, поэтому их легко встроить в существующую инфраструктуру.
Веса выложены на GitVerse и Hugging Face под лицензией MIT: